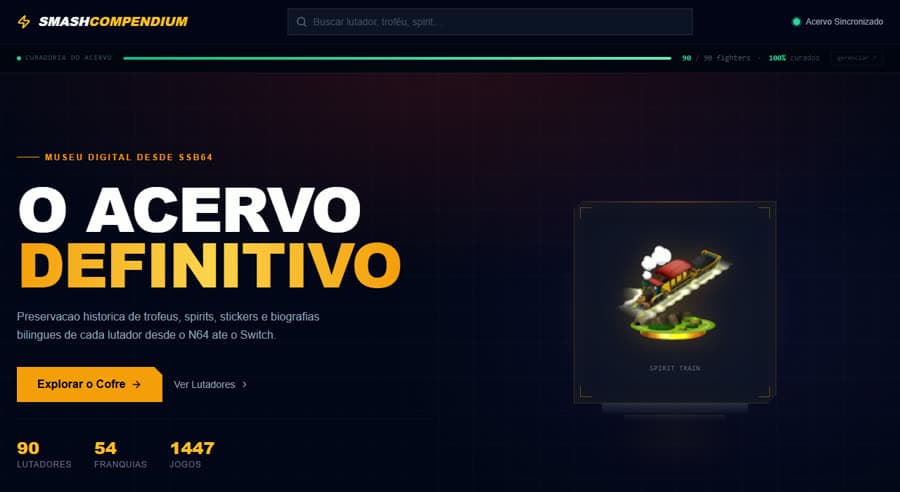
Sempre gostei de catalogar coisas. Muito antes de saber o que era um banco de dados relacional, eu já enchia cadernos com listas de personagens, movesets, combos e franquias de Super Smash Bros. — o tipo de obsessão organizada que, sem eu perceber, já era um treino disfarçado de modelagem de dados. Era só uma questão de tempo até essas duas paixões, Smash Bros. e engenharia de dados, se encontrarem em forma de projeto. O resultado se chama Smash Compendium.
A franquia tem uma história gigantesca e espalhada por dezenas de fontes diferentes: wikis, fóruns, planilhas feitas pela comunidade, vídeos de análise — cada uma com um pedaço da verdade e nenhuma com o quadro completo. Toda vez que eu ia procurar algo específico (quantas franquias já passaram pelo jogo? quantos troféus existem desde o Melee? em qual álbum está aquela trilha sonora?), eu terminava com seis abas abertas e nenhuma resposta definitiva. O Smash Compendium nasceu da vontade de resolver esse problema pra mim mesmo primeiro, e depois pra qualquer outro fã que sofresse do mesmo mal.
De fã organizador a pipeline de ETL
Assim que decidi levar a ideia a sério, tratei o projeto como eu trataria qualquer sistema de dados de verdade, não como uma lista feita à mão. Implementei um pipeline de ETL (Extract, Transform, Load) pra ingerir dados de diversas fontes, com destaque para a SSBWiki: extrair as informações brutas, normalizar as inconsistências de nomenclatura e formatação entre fontes diferentes, e carregar tudo numa estrutura de banco relacional pensada pra consulta rápida, não só pra armazenamento.
O resultado hoje mapeia 90 lutadores, 54 franquias e mais de 1.400 títulos associados a esse universo — tudo relacionado entre si, então navegar de um personagem até o jogo original dele, ou de uma franquia até todos os lutadores que ela originou, é uma questão de clique, não de pesquisa manual.
Curadoria de troféus, spirits, stickers e trilhas sonoras
A parte mais trabalhosa não foi cadastrar os lutadores — foi organizar tudo que orbita em volta deles. Troféus do Melee, Spirits do Ultimate, stickers do Brawl e trilhas sonoras de gerações diferentes de jogos têm formatos de dados completamente diferentes entre si, e a plataforma precisa apresentar isso de forma coesa e com performance, mesmo com um volume grande de itens sendo filtrados e renderizados ao mesmo tempo. Foi um exercício real de pensar estrutura de dados e experiência do usuário como a mesma decisão, não como etapas separadas.
O que esse projeto pessoal me ensinou
O Smash Compendium é uma prova de como dá pra aplicar boas práticas de desenvolvimento — desde a modelagem de dados até a experiência do usuário — em projetos pessoais, sem precisar de um cliente ou de uma empresa por trás pra justificar o cuidado técnico. Convido a comunidade de desenvolvedores e os entusiastas de games a explorarem o acervo. E fica a pergunta que eu mesmo ainda estou tentando responder: como podemos melhorar ainda mais a integridade desses dados? Fico no aguardo de feedbacks técnicos.
O projeto está no ar em smashcompendium.com, e o código é aberto no GitHub.
Anderson Crush
Desenvolvedor Full Stack